用户实践:微众银行 AI智能体 运维落地实践
微众银行选用轻量化国产OpenOcta搭建数据库AI运维,沉淀96项运维技能,覆盖600+多引擎数据库实例。DBA由运维操作员转为审批者,故障排查效率最高提升144倍,上线一月零安全事故,大幅释放人力聚焦架构优化
一凌晨 2:37
凌晨 2:37,值班手机震动。
"10.108.xx.xx 从库延迟持续超过 600s"——告警来了。
打开企业微信,@AI 运维助手,发了一句:"帮我看一下这个仓库怎么回事。"
12.5 秒后,AI 返回了诊断结果:3 个运行时间长的慢查询阻塞主库 binlog 同步,导致从库延迟。附带 Kill 建议。
DBA 回复"确认执行",2 分钟内延迟恢复正常。
整个过程,DBA 只做了一件事——在手机上确认。
| " |
二600+ 数据库实例,1 个人
和大多数金融机构一样,微众银行的数据库环境极具挑战:
| 600+数据库实例 · 多引擎混合(TDSQL / TiDB / WeRedis / PostgreSQL / Milvus)· 1 人值班 |
传统做法:收到告警 → 开电脑 → 连 VPN → 登录跳板机 → 查监控 → 分析 SQL → 手动操作。一个慢查询诊断就是 15~20 分钟。夜间被叫醒到真正开始处理,至少 10 分钟。
更痛苦的是批量巡检:磁盘、连接数、慢查询趋势、主从延迟、大表增长……巡检项多,全靠人肉排查效率低。日复一日盯着同样的指标,告警疲劳下容易漏掉真正的异常。巡检和故障处理争抢时间,巡检永远排不上优先级。
| " |
三从"操作员"到"指挥官"
AI 带来的最大变化不是速度,而是角色转变:
传统流程 📱 告警 → 😴 被叫醒→ 💻 开电脑 → 🔒 连 VPN→ 🖥️ 登录跳板机 → 📊 查监控→ 🔍 分析 SQL → 🛠️ 手动操作 ⏱ 全流程: 15~20 分钟 👤 角色: 操作者——每个环节都要亲自做 | AI 流程 📱 手机看诊断报告→ ✅ 确认执行 ⏱ 全流程: ~2 分钟 👤 角色: 审批者——AI 执行,DBA 决策 |
| " |
这个转变不是靠换人,而是靠换工具。
四真实场景
🔍 场景 1:慢查询诊断
144x 提升
TOP 1· 耗时 23.7s · 执行 47 次 SELECT * FROM trade_record WHERE create_time > ? AND status = ?扫描行数 1,280 万,索引命中率仅 3.2% 建议:添加 (create_time, status)联合索引,预计优化后耗时 < 0.1sTOP 2· 耗时 8.4s · 执行 12 次 SELECT COUNT(*) FROM user_order WHERE merchant_id = ?全表扫描,该表 560 万行 建议:添加 (merchant_id)索引TOP 3· 耗时 4.2s · 执行 3 次 已有索引命中,为批量报表查询,建议调整到业务低峰期执行。 |
| 接入前 | 接入后 |
✨ 效率提升 144 倍
🔄 场景 2:从库延迟告警
10x 提升
延迟原因:3 个长时间运行的慢查询阻塞主库 binlog 同步 影响范围:该从库服务 12 个业务读取,当前延迟 623s 操作建议:Kill 以下 3 个查询可恢复同步 Query ID 23451 · 运行 892s · SELECT ... FROM order_detailQuery ID 23487 · 运行 567s · SELECT ... FROM user_session WHERE ...Query ID 23502 · 运行 423s · SELECT ... FROM trade_record |
| 接入前 | 接入后 |
✨ 效率提升 10 倍
📋 场景 3:600+ 实例健康状态检查
30x 提升
✅ 正常:~550 个实例 ⚠️ 警告:~45 个实例需关注 🔴 异常:少量实例需立即处理 TOP 5 异常实例: 1. 10.108.xx.21 · 磁盘使用率 92.3%(日增 1.8%,预计 4 天写满) 2. 10.108.xx.35 · 连接数 287/300(连接池接近满载) 3. 10.108.xx.48 · 从库延迟 234s(持续增长中) 4. 10.107.xx.12 · 慢查询数较昨日增长 340% 5. 10.107.xx.67 · 内存使用率 89%(接近 OOM 阈值) 建议:优先处理 #1(磁盘)和 #3(从库延迟),其他建议今天内处理。 |
需清理: 1. audit_log 120GB · 归属:风控子系统 · 负责人:张三2. trade_record 85GB · 归属:交易子系统 · 负责人:李四3. user_behavior 43GB · 归属:用户子系统 · 负责人:王五已向三位负责人发送企微通知,附大表详情和清理建议。预计清理后磁盘使用率从 92.3% 降至 61%。 |
| 接入前 | 接入后 |
✨ 效率提升 30 倍
📊 场景 4:SQL 耗时突增识别
600+ 实例每天产生海量 SQL,其中绝大多数是正常的。但偶尔会有某条 SQL 的耗时从 5ms 悄悄跳到 50ms——慢查询阈值都够不上,却在高并发下拖垮整个联机链路。这种"隐形的性能杀手",人工根本找不出来。
1. SELECT ... FROM order_detail WHERE status=? 近 7 天平均 3.2ms → 近 24 小时飙升至 47ms(↑14.7 倍) 原因:数据量从 120 万增长到 380 万,索引命中率下降 建议:添加 (status, created_at) 联合索引2. UPDATE user_session SET last_active=? WHERE user_id=? 近 7 天平均 1.8ms → 近 24 小时升至 23ms(↑12.8 倍) 原因:连接池泄漏导致锁等待 建议:检查应用连接池配置,当前活跃连接数 287/最大 300 |
| 核心价值: |
🔍 场景 5:TDSQL 主备切换异常分析(多 Agent 协作)
15x 提升
TDSQL 主备异常切换是最让 DBA 头痛的故障之一——原因可能藏在 MySQL 错误日志、Agent 日志、Scheduler 日志、主机系统日志、ZooKeeper 日志的任意一个里。以前 DBA 要逐个登录、逐条翻日志,拼凑时间线,一次分析至少 30 分钟。
现在,多个 Agent 同时工作,各自负责不同日志源:
Agent 1 MySQL | Agent 2 TDSQL | Agent 3 Scheduler | Agent 4 主机 | Agent 5 ZooKeeper |
① 主机系统日志(Agent 4):02:14 磁盘 IO 抖动,iostat 显示 %util 从 12% 飙到 94%,持续 38 秒 ② TDSQL Agent 日志(Agent 2):02:14:23 心跳写入失败(IO 超时),连续 3 次未上报 ③ ZooKeeper 日志(Agent 5):02:14:41 节点心跳超时,触发 master 重新选举 ④ Scheduler 日志(Agent 3):02:14:43 下发主备切换指令 ⑤ MySQL Error Log(Agent 1):02:14:45 主库释放锁,备库提升为新主 根因结论:主机磁盘 IO 抖动 → Agent 心跳写不进去 → ZooKeeper 判定节点下线 → 触发主备切换。 建议:检查主机磁盘健康状态(smartctl -a),排查是否有其他进程抢占 IO。 |
接入前 逐台登录翻日志 → 手动拼时间线 → ~30 分钟 | 接入后 5 Agent 并行分析 → 自动拼链路 → 2 分钟出报告 |
| 关键突破: |
📈 场景 6:智能巡检提前 6 天预警
当前状态:磁盘使用率 78.5% · 剩余空间 43.2GB 日均增长:1.8GB/天(较上周增长 12%) 主要增长来源: · binlog 日均 0.8GB(保留期 14 天,可优化) · audit_log 日均 0.6GB(90 天前数据可归档) · 业务数据日均 0.4GB(正常增长) ⚠️ 预警:按当前增速,预计 6 天后达到 90% 告警阈值。 建议: 1. 立即:清理 audit_log 90 天前数据,释放 ~54GB 2. 本周:binlog 保留期从 14 天调整为 7 天,释放 ~12GB 3. 中期:申请扩容磁盘至 500GB |
| 核心教训: |
五ROI 量化总结
| 144x | |||
| 10x | |||
| 30x | |||
| 从 0 到 1 | |||
| 15x | |||
| 从 0 到 1 |
上线 1 个月以来的运行数据:
832 总咨询量 | 692 工具调用 |
100% 服务可用性 | 0 安全事故 |
48 活跃用户 | ~49 日均调用 |
4.8 满意度评分 | 600+ 日均覆盖实例 |
205 会话全量追溯 |
| " |
六为什么是 OpenOcta?
构建 AI 运维助手,第一个选择不是"怎么搭",而是"用什么搭"。2025 年底市面上的 AI Agent 框架已经不少,我们圈定了三个候选,花了两周做技术评估。
| 开发语言 | |||
| 部署效率 | |||
| 资源开销 | |||
| 安全管控 | |||
| 企微协同 | |||
| 协议标准 | |||
| 离线部署 | |||
| 审计追溯 | |||
| 二次开发 |
真实决策维度
圈定三个候选后,我们从四个维度做了评估:
先试了 Dify。 当时 Dify 最火(50k+ stars),社区活跃,可视化工作流编排很吸引人。但框架较重,上手难度大,团队从现有技术栈迁移过来成本高,后续运维负担也不轻。
再看 OpenClaw。 GitHub 上最火的数据库 AI Agent,功能丰富,社区活跃。但功能越多,暴露面越大——漏洞频发,安全补丁跟不上。我们是垂类场景,不需要大而全的平台,反而需要做减法:只保留数据库运维相关的能力,砍掉多余的功能模块。
最后试了 OpenOcta。 四个关键因素让我们最终定下来:
🇨🇳 关键因素 1:全栈国产化Go 语言开发,国产化生态兼容性好,可编译为单二进制在银河麒麟等国产 OS 上运行。chroot 隔离 + SkillsOnly 白名单满足金融行业安全合规要求。 |
📦 关键因素 2:轻量化部署单 Go 二进制 ~50MB,scp 传上去就能跑,零依赖。跳板机 4 核 8GB 轻松承载,内存占用仅 ~50MB。选 OpenOcta 最直接的原因:它真的能在我们的机器上跑起来。 |
👥 关键因素 3:团队可维护性Go 单二进制架构,整个系统只有 1 个进程,DBA 团队独立完成部署、升级、回滚,不依赖其他团队。 |
⚠️ 关键因素 4:社区生态(需关注)客观说,OpenOcta 的社区活跃度远低于 Dify(50k+ stars)和 OpenClaw。选择 OpenOcta 是在生态上做了取舍——换来了安全可控和轻量部署。更重要的是,我们在开源代码基础上进行了深度改造:新增了 SkillsOnly 白名单模式,只允许 AI 执行预注册的运维技能,从架构层面杜绝了越权操作。这也是我们 fork 独立维护的原因。 |
选型定下来后,我们基于 OpenOcta 的 Skills 机制把 DBA 团队的经验固化为运维技能包——慢查询诊断、磁盘巡检、SQL 耗时分析,这些占 DBA 日常 80% 的重复工作通过 Skills 固化下来,AI 自动执行。不是造一个庞大的管理平台,而是做减法——把团队的知识直接变成 AI 的能力。
| " |
七96 个工具怎么搭
我们基于 OpenOcta 和自研 AI-数据库中间件,正式构建了数据库 AI 运维助手。整个架构分为 7 层:
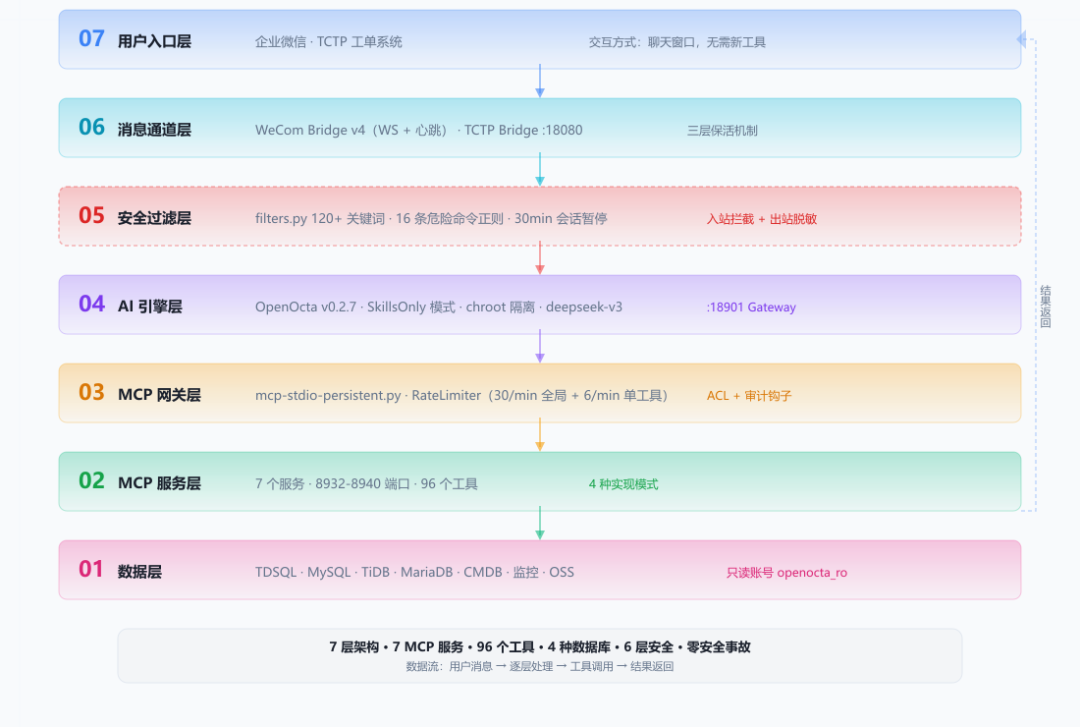
系统架构:7 层分层设计,从用户入口到数据层全链路覆盖
消息从用户发出到返回,经过完整的请求/响应闭环:
全链路数据流转:一条消息的请求/响应闭环
WebSocket | 协议转换/审批 | OpenOcta chroot | 限流/ACL/审计 | 7 服务 96 工具 |
🔽 请求路径
实际数据库实例与监控系统 |
🟢 响应路径
结果返回 | 脱敏处理 | 格式化+评分 | 推送给用户 | 手机查看/确认 |
全程 < 30 秒 · 请求路径(蓝)与响应路径(绿)构成完整闭环 · 途经 6 个节点
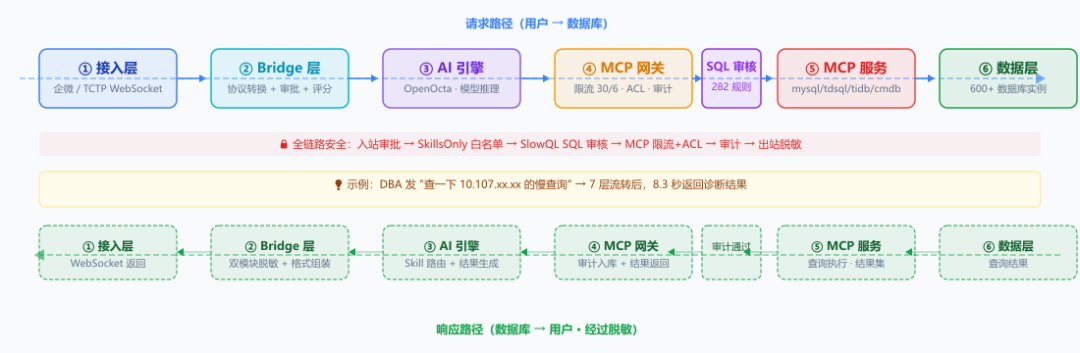
请求路径(蓝)与响应路径(绿):一条消息穿越 6 层后返回
关键在 MCP(Model Context Protocol)层——它把数据库操作能力标准化为 96 个工具,覆盖 7 个 MCP 服务:
| 💡 有意思的发现: |
| query_slow_log | ||||
| search_instances | ||||
| get_disk_usage | ||||
| show_processlist | ||||
| get_metric_trend |